Claude Codeにスキルを追加しても、実際に何がよくなったのかは少し分かりづらいと感じていました。呼び出された記録があっても、欲しかった回答になったかは別の話です。
今回は小さな障害引き継ぎ用スキルを作り、同じ質問をスキルあり・なしで比べました。見る対象は呼び出し回数と点数、それから実際の文章です。
スキルを呼んだことと、成果が変わることを分ける
Claude Codeのスキルは、SKILL.mdに用途と手順を書いておく仕組みです。descriptionを手がかりに、質問に合うスキルが選ばれます。
公式のSkillsドキュメントにも、発火と出力の評価は分け、新しいセッションで有無を比較する考え方が載っています。今回はプラグインとしてまとめ、claude plugin evalを使います。
普段使うスキルを大量に入れると、どの指示が効いたのか分かりません。そのため、スキル1個だけのプラグインにしました。実際の障害情報は使わず、API障害とCSV取り込み失敗の架空の状況を用意しています。
引き継ぎメモ用の小さなスキルを作る
検証した環境はmacOS、Claude Code 2.1.295、Git 2.50.1です。既存のClaude Code環境とログインを使えたので、追加インストールは不要でした。
ディレクトリは次の形にしました。
claude-skill-eval/
├── .claude-plugin/plugin.json
├── skills/incident-handoff/SKILL.md
└── evals/
    ├── api-502/
    │   ├── prompt.md
    │   └── graders/
    │       ├── content-quality.md
    │       ├── handoff-format.md
    │       └── skill-fired.md
    └── csv-import/
        ├── prompt.md
└── graders/ # 同じ3種類の判定を配置plugin.jsonは最低限の内容です。
{
  "name": "incident-notes",
  "version": "1.0.0",
  "description": "Small incident handoff skill for a controlled blog experiment"
}
スキルには、原因を断定しないこと、次の確認を絞ること、担当者や期限を勝手に補わないことを書きました。難しい知識を追加するというより、私が引き継ぎメモで揃えたい点をまとめた形です。
---
name: incident-handoff
description: 障害対応の状況共有、一次報告、引き継ぎメモを作成するときに使います。ログや時系列から、事実と仮説を分け、次に担当者が確認することを短くまとめます。
---
# 障害引き継ぎメモ
日本語の短い引き継ぎメモを作成してください。

- 見出しは「確認済みの事実」「未確認・仮説」「次の確認」「引き継ぎ事項」の4つにします。
- 与えられた時刻、数値、エラー名を保ちます。入力にない原因や実施結果を作りません。
- 時間的に前後しただけの事象を因果関係と断定しません。確認した範囲と未確認の範囲を分けます。
- 次の確認は3件以内に絞ります。それぞれに確認対象と、その結果から何を判断するかを書きます。
- 担当者、期限、次回更新時刻が入力にない場合は未定と書きます。架空の人名や時刻は補いません。
- 未実施の操作は提案として書き、実行済みと混同しません。
- 返答は本文のみ。追加情報を待って止まらず、不明点をメモに残します。
同じ質問を2件用意する
1件目は、デプロイ後にAPIの502が増えた状況です。バージョンを戻すとエラー率は下がっています。ただ、正常時の数値を調べていないので、復旧したと言い切れる材料はありません。
evals/api-502/prompt.mdには次の内容を入れました。スキル名やスラッシュコマンドは質問に書いていません。自然な依頼で選ばれるかも見たかったためです。
---
runs: 3
max_turns: 6
timeout_seconds: 180
allowed_tools: [Read, Glob, Grep, Skill]
---
API障害について、次の担当者に渡す短い引き継ぎメモを作ってください。
10:05にv1.8.0をデプロイ。10:07からALBの502が増え、10:10時点で5xx率は12%。
10:12のアプリログにDB connection timeoutが20件。DB CPUは35%、接続数は未確認。
10:15にv1.7.9へ戻した。10:20の5xx率は1%になったが、通常値とDBログはまだ確認していない。
原因はまだ分からない。長い一般論ではなく、今ある情報で共有できる内容と次に確認することをまとめてください。2件目はCSVです。失敗した37件のうち、確認したのは3件だけという条件を入れました。3件を見て、残りも同じ原因だと決めつけないかを見ます。prompt.mdの設定部分は1件目と同じです。
CSV取り込みが一部失敗したので、チームへの一次報告を短くまとめてください。
09:00のバッチで1,000件中37件が失敗。失敗行のエラーはinvalid date。
手元で確認した3行はいずれも日付が2026/10/08だった。取り込み仕様はYYYY-MM-DD。
先週のCSVは成功している。CSVの出力元が変わったかは未確認。
本番での再実行はまだしていない。成功した963件をもう一度取り込んだ場合に重複するかも未確認。
原因を決めつけず、次の作業に進めるメモにしてください。
判定は、呼び出し・内容・形式の3つにする
ここは少し迷いました。見出しが揃うことと、障害の切り分けが適切なことを、一つの点数で表すと読み違えそうです。
今回は次の3種類を用意し、結果でも分けて確認します。採点条件は実行前に決めています。
| 判定 | 確認すること | 総合点への扱い |
|---|---|---|
| skill-fired | 対象のSkillが呼び出されたか | 記録のみ |
| content-quality | 数値・時系列を保ち、未確認事項を断定せず、次の確認を提案できたか | 1項目として採点 |
| handoff-format | 指定の4見出しが順番に出たか | 1項目として採点 |
内容と形式は同じ重みです。両方通れば1.00、片方だけなら0.50になります。この点数は、回答の品質全般を表すものではありません。半分は、こちらがスキルにだけ教えた書式への適合です。
呼び出し判定はgraders/skill-fired.mdに置きました。
---
type: tool_used
tool: Skill
input_match: '"skill"\s*:\s*"(?:[\w-]+:)?incident-handoff"'
---内容はllm判定です。API側は時刻・数値の保持、原因と復旧を断定しないこと、DBや正常時の値の確認、未実施作業の捏造がないことを条件にしました。CSV側は件数の保持、3件の観察と全件の原因を区別すること、残りの失敗行と再実行前の重複確認、未実施作業の捏造がないことです。見出しや言い回しでは判定しないよう明記しました。
形式は正規表現です。graders/handoff-format.mdを次のようにしました。
---
type: regex
pattern: '確認済みの事実[\s\S]*未確認・仮説[\s\S]*次の確認[\s\S]*引き継ぎ事項'
---
plugin evalを実行する
実行コマンドは次のとおりです。作業ディレクトリはプラグインのルートです。
claude plugin validate .
claude plugin eval . \
  --model sonnet \
  --runs 3 \
  --ablation with-without \
  --concurrency 1 \
  --max-cost-usd 5 \
  --no-publish \
  --trust-plugin \
  --output-dir evals/results/20261009-main \
--report evals/results/20261009-main/report.html--trust-pluginは、今回自分で作成し、内容を確認したプラグインに使っています。Bashの実行や外部MCPサーバーは追加していません。
2問×3回×あり・なしの2条件なので、回答生成は12回です。判定モデルによる評価も利用量に含まれます。--no-publishでレポートはローカルに保存しました。
12回の結果は、スキルありの点数が高かった
実行はエラーなく完了しました。モデル指定はsonnet、判定モデルは既定値です。固定のモデルIDではないため、後日の同じコマンドが同じモデルを使うとは限りません。
総所要時間は224秒、レポートの参考コストは約0.40ドルでした。JSONでは0.3959881ドルです。これは定価ベースの推計で、今回のTeam契約に追加請求された金額ではありません。実行分は契約の利用量を消費します。
| 質問 | スキルありの平均点 | スキルなしの平均点 | 差 |
|---|---|---|---|
| APIの502増加 | 1.00 | 0.50 | +0.50 |
| CSVの取り込み失敗 | 1.00 | 0.33 | +0.67 |
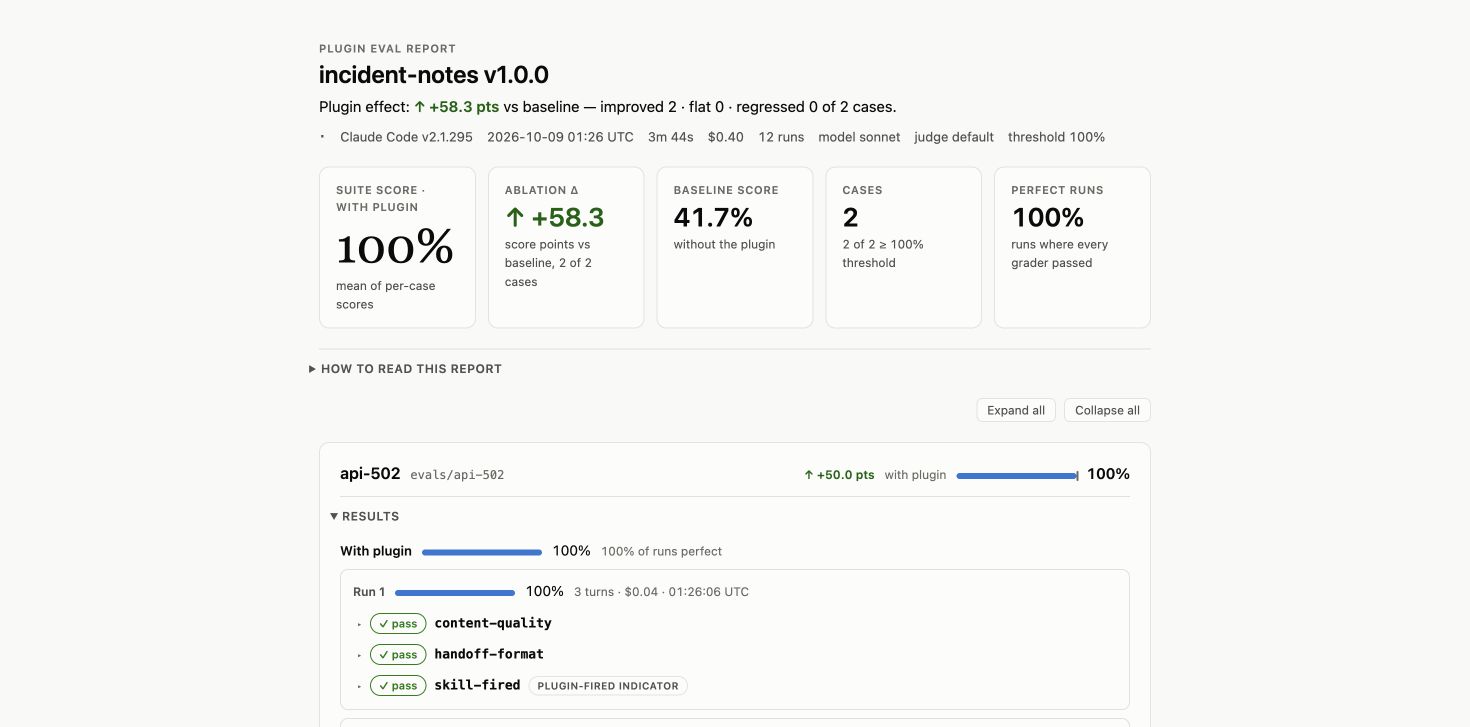
最初は、この表だけで効果を説明できそうに思いました。ただ、内訳を見ると印象が変わります。
| 質問と条件 | 内容判定の合格 | 指定形式の合格 | 対象スキルの呼び出し |
|---|---|---|---|
| API・あり | 3/3 | 3/3 | 各回1回、計3回 |
| API・なし | 3/3 | 0/3 | 対象プラグインなし |
| CSV・あり | 3/3 | 3/3 | 各回1回、計3回 |
| CSV・なし | 2/3 | 0/3 | 対象プラグインなし |
APIでは内容判定の差はありません。総合点の差はすべて、指定した見出しを使ったかどうかです。スキルなし側にはその見出しを教えていないので、ここが低いのは想定内でした。
出力の違いは、確認項目の数と引き継ぎ欄に出た
APIの出力を読むと、スキルなしでも通常値の確認、DB接続数、DBログ、バージョン差分に触れています。必要な観点がまったく出ないわけではありません。
違いが見えたのは、次の確認の絞り方です。あり側は3回とも番号付きの確認項目が3件でした。なし側は順に6件、5件、6件です。あり側では、その確認結果から何を判断するかも文章で書かれていました。
たとえば、API・あり側の1回目には次の記述がありました。以下は実際の回答からの抜粋です。
5xx 率の通常値と 10:20 以降の推移(ALB メトリクス)
通常値と同水準で安定していれば、ロールバックで復旧したと判断します。1% が通常より高い、または再上昇する場合は、別要因の残存を疑って調査を続けます。末尾には、担当者・対応期限・次回更新時刻が未定として残りました。なし側の3回には、この3項目を揃えた欄はありません。
私が今回欲しかったのは、調査項目をできるだけ多く挙げることより、次の担当者が読む形に整えることです。その点では、スキルに書いた方針が出力に現れたと感じました。ただ、項目が3件でも各項目は長く、必ずしも文章全体が短くなるわけではありません。
CSVの判定は、そのまま信じにくかった
CSVのなし側2回目は、内容判定が3票ともFAILでした。ところが、出力には次の記述があります。
1. 失敗37件全行の日付形式を確認する(全件スラッシュ区切りか、他のパターンはないか)。
4. 再取り込みの重複有無(一意キー・upsert可否など)を、本番再実行の前に確認する。
5. 上記が分かるまで、本番での再実行は保留する。
抜粋の番号が飛んでいるのは、比較に必要な行だけを取り出したためです。回答全体には3件しか確認していないことや、原因が未確定であることも書かれていました。
確認の目的の説明が弱いと判定された可能性はあります。ただ、保存された結果には投票と判定対象の文章があり、どの条件で落ちたかの個別理由はありません。私が読んだ範囲では、内容が明確に悪化した1回とは言い切れませんでした。
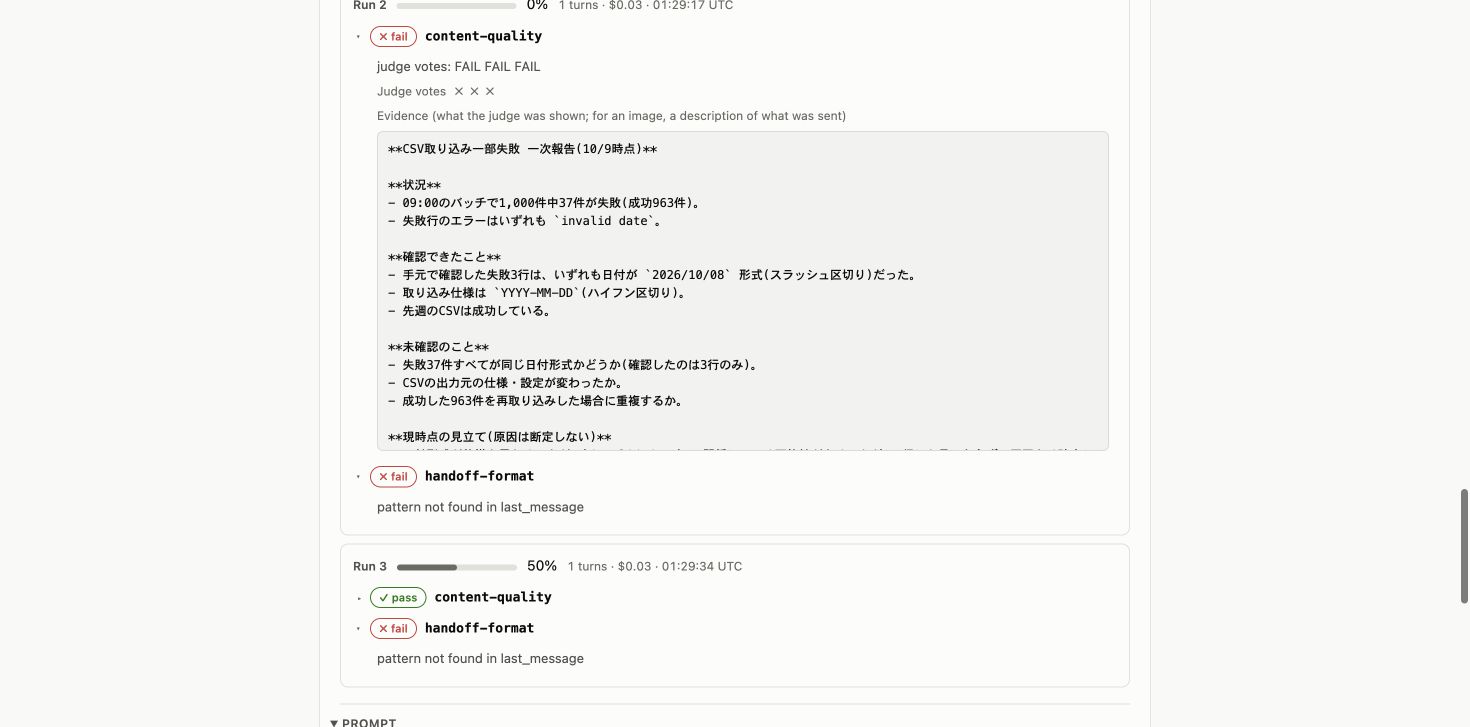
反対に、なし側3回目は合格でしたが、入力にはない影響範囲の拡大はなしという記述がありました。APIのあり側にも、入力で明示していないDB CPUの観測時刻を10:12時点と補った回答があります。スキルを呼んで満点だったから、細部まで正しいとは言えません。
ここは採点条件の作り方も反省点です。入力にない情報を補わないというスキルの方針に対し、判定条件は作業実績・担当者・期限などの捏造に絞っていました。条件の外側にある補足までは、十分に検出できていません。
そのため、CSVの内容判定が3/3対2/3だったことは自動採点の結果として残しますが、品質改善を証明した数字としては扱わないことにしました。
今回分かったことと、次に試したいこと
自分の環境では、スキルを利用可能にしておくと、自然な質問から6回とも呼び出されました。見出し、確認項目の数、引き継ぎ欄には、書いておいた指示の違いが出ています。
一方で、スキルなしでも内容はかなり揃っていました。今回は質問自体に原因を決めつけないよう書いているので、その指示が効いている可能性もあります。比較したのは、この2問に対する追加の効果です。あらゆる仕事でスキルを入れるだけで品質が上がる、とは言えません。
また、同じ指示を毎回の質問に直接書く条件とは比較していません。スキルという仕組み自体の優位性と、指示を追加した効果も分ける必要があります。
次は内容判定を複数の小さな条件に分け、観測していない情報の補足も拾えるようにしたいと思います。短い質問や、このスキルを使うべきでない質問も加えて、形式を揃える便利さと、回答の正確さを別々に見ていきます。
実行仕様の確認には、Claude Codeのplugin eval公式ドキュメントを参照しました。今回使った--max-cost-usdは次の実行を始める前に確認されるため、実行中の1回分で指定値を超える可能性があります。
ここまで読んでいただき、ありがとうございます。もしこの記事の技術や考え方に少しでも興味を持っていただけたら、ネクストのエンジニアと気軽に話してみませんか。
- 選考ではありません
- 履歴書不要
- 技術の話が中心
- 所要時間30分程度
- オンラインOK


