エージェントの返答がおかしいとき、モデルへの入力とツールの結果を同じ画面で追えたら助かります。2026年9月に公開されたAmazon CloudWatch OmniのIDE拡張が気になり、手元のVS Codeで小さなエージェントを動かしてみました。
2026年9月29日時点の技術メモです。ローカルでモデル呼び出しとツール実行を各1回行い、Omniに表示された内容を記録しました。クラウドモードと評価機能は試していません。
CloudWatch OmniのIDE拡張とは
CloudWatch Omniは、アプリケーションとAIエージェントのテレメトリーを扱うCloudWatchの新しい画面です。AWSの発表では、Web画面とは別に、VS Code、Cursor、Kiro向けのIDE拡張が案内されています。
拡張にはローカルとクラウドのモードがあります。拡張のMarketplaceページによると、ローカルモードはプロジェクト内の.omni/にトレースを保存し、AWSアカウントは不要です。ただし、モデルを実際に呼ぶには、そのモデルプロバイダーの認証情報が要ります。AWSアカウント不要を、モデル呼び出しも無条件に無料という意味に捉えかけました。ここは分けて考える必要があります。
CloudWatch Omniを何に使うか
私がまず使いたいのは、エージェントが正常終了したのに答えが違うときの切り分けです。例えば会議室Aの空き時間を聞いたのに、空きなしと返ったとします。モデルへの入力、lookup_roomに渡した部屋番号、ツールが返した時間枠、最後の回答を同じトレースで追います。部屋番号がBならツールへ渡す引数を、時間枠が正しいのに回答が違うならモデルへの指示を疑えます。Agent tracesの説明でも、1回の実行をspanごとに見て、ツールの引数や入出力を確認する使い方が案内されています。今回の検証では誤答は再現していませんが、この切り分けに必要な情報がどこまで見えるかを確かめました。
もう一つは、プロンプト変更後の品質低下です。社内FAQのエージェントが返品条件の例外を答えなくなっても、処理自体は成功します。エラー件数だけでは気づきにくい問題です。AWSの品質回帰を修正するチュートリアルでは、本番で失敗した実行をテスト用データセットに入れ、IDEで修正前後を同じ条件で評価し、デプロイ後も継続して採点しています。これはクラウドのspaceと評価機能を使う流れで、今回のローカル検証では試していません。
本番で応答が遅くなったときも用途がありそうです。たとえば問い合わせエージェントの処理時間が急に伸びた場合、OmniのWeb画面で遅延やトークン使用量の変化を見て、該当するトレースのモデル呼び出しとツール実行を開きます。モデル待ちなのか、データ取得が遅いのかを絞り込む使い方です。ただし、画面に出る情報は計装次第です。今回の手書きspanではトークン使用量を送っておらず、表示は0でした。
VS Codeに入れてみた
手元はmacOSのarm64、VS Code 1.137.0、Node.js 25.4.0です。VS Code Marketplaceから、発行元がAmazon Web ServicesのAmazon CloudWatch Omniをインストールしました。確認した拡張のバージョンは1.0.0です。
拡張を入れただけでは、ローカルの実行履歴は表示されません。最初はフォルダーを開いておらず、Localが無効でした。プロジェクトを開くとローカルモードに切り替わり、.omni/と.env.omniが作られました。
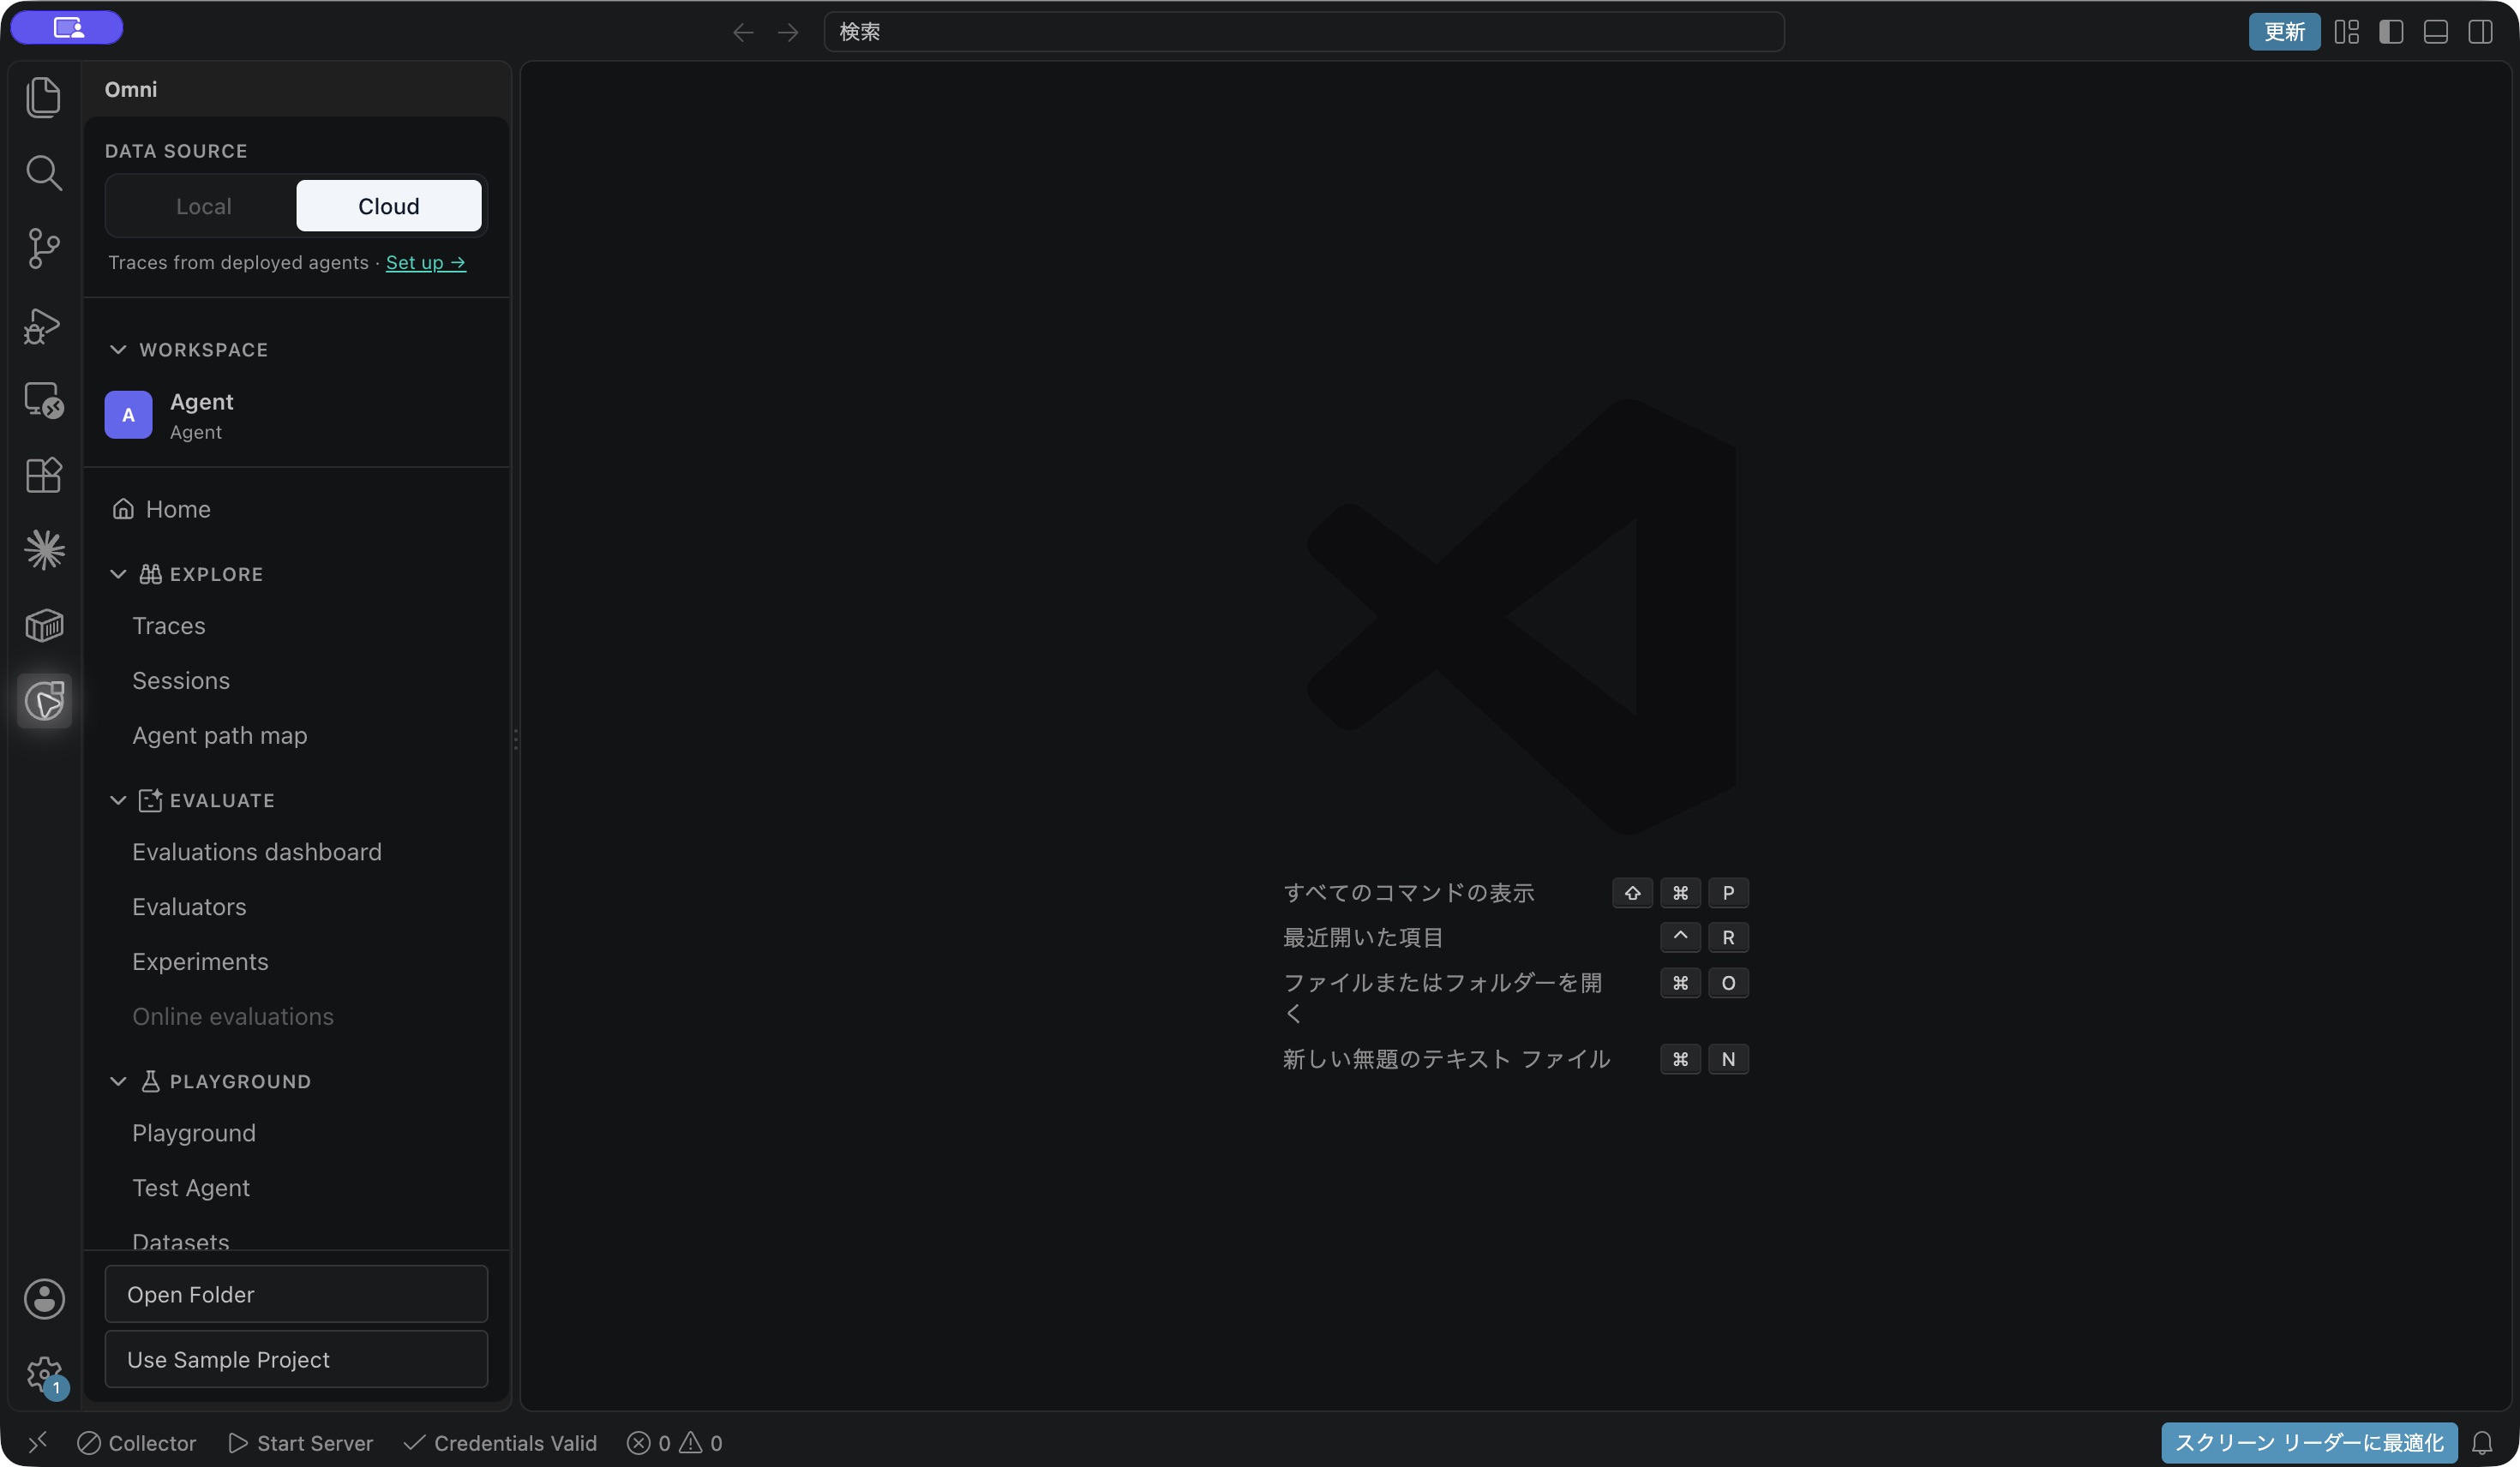
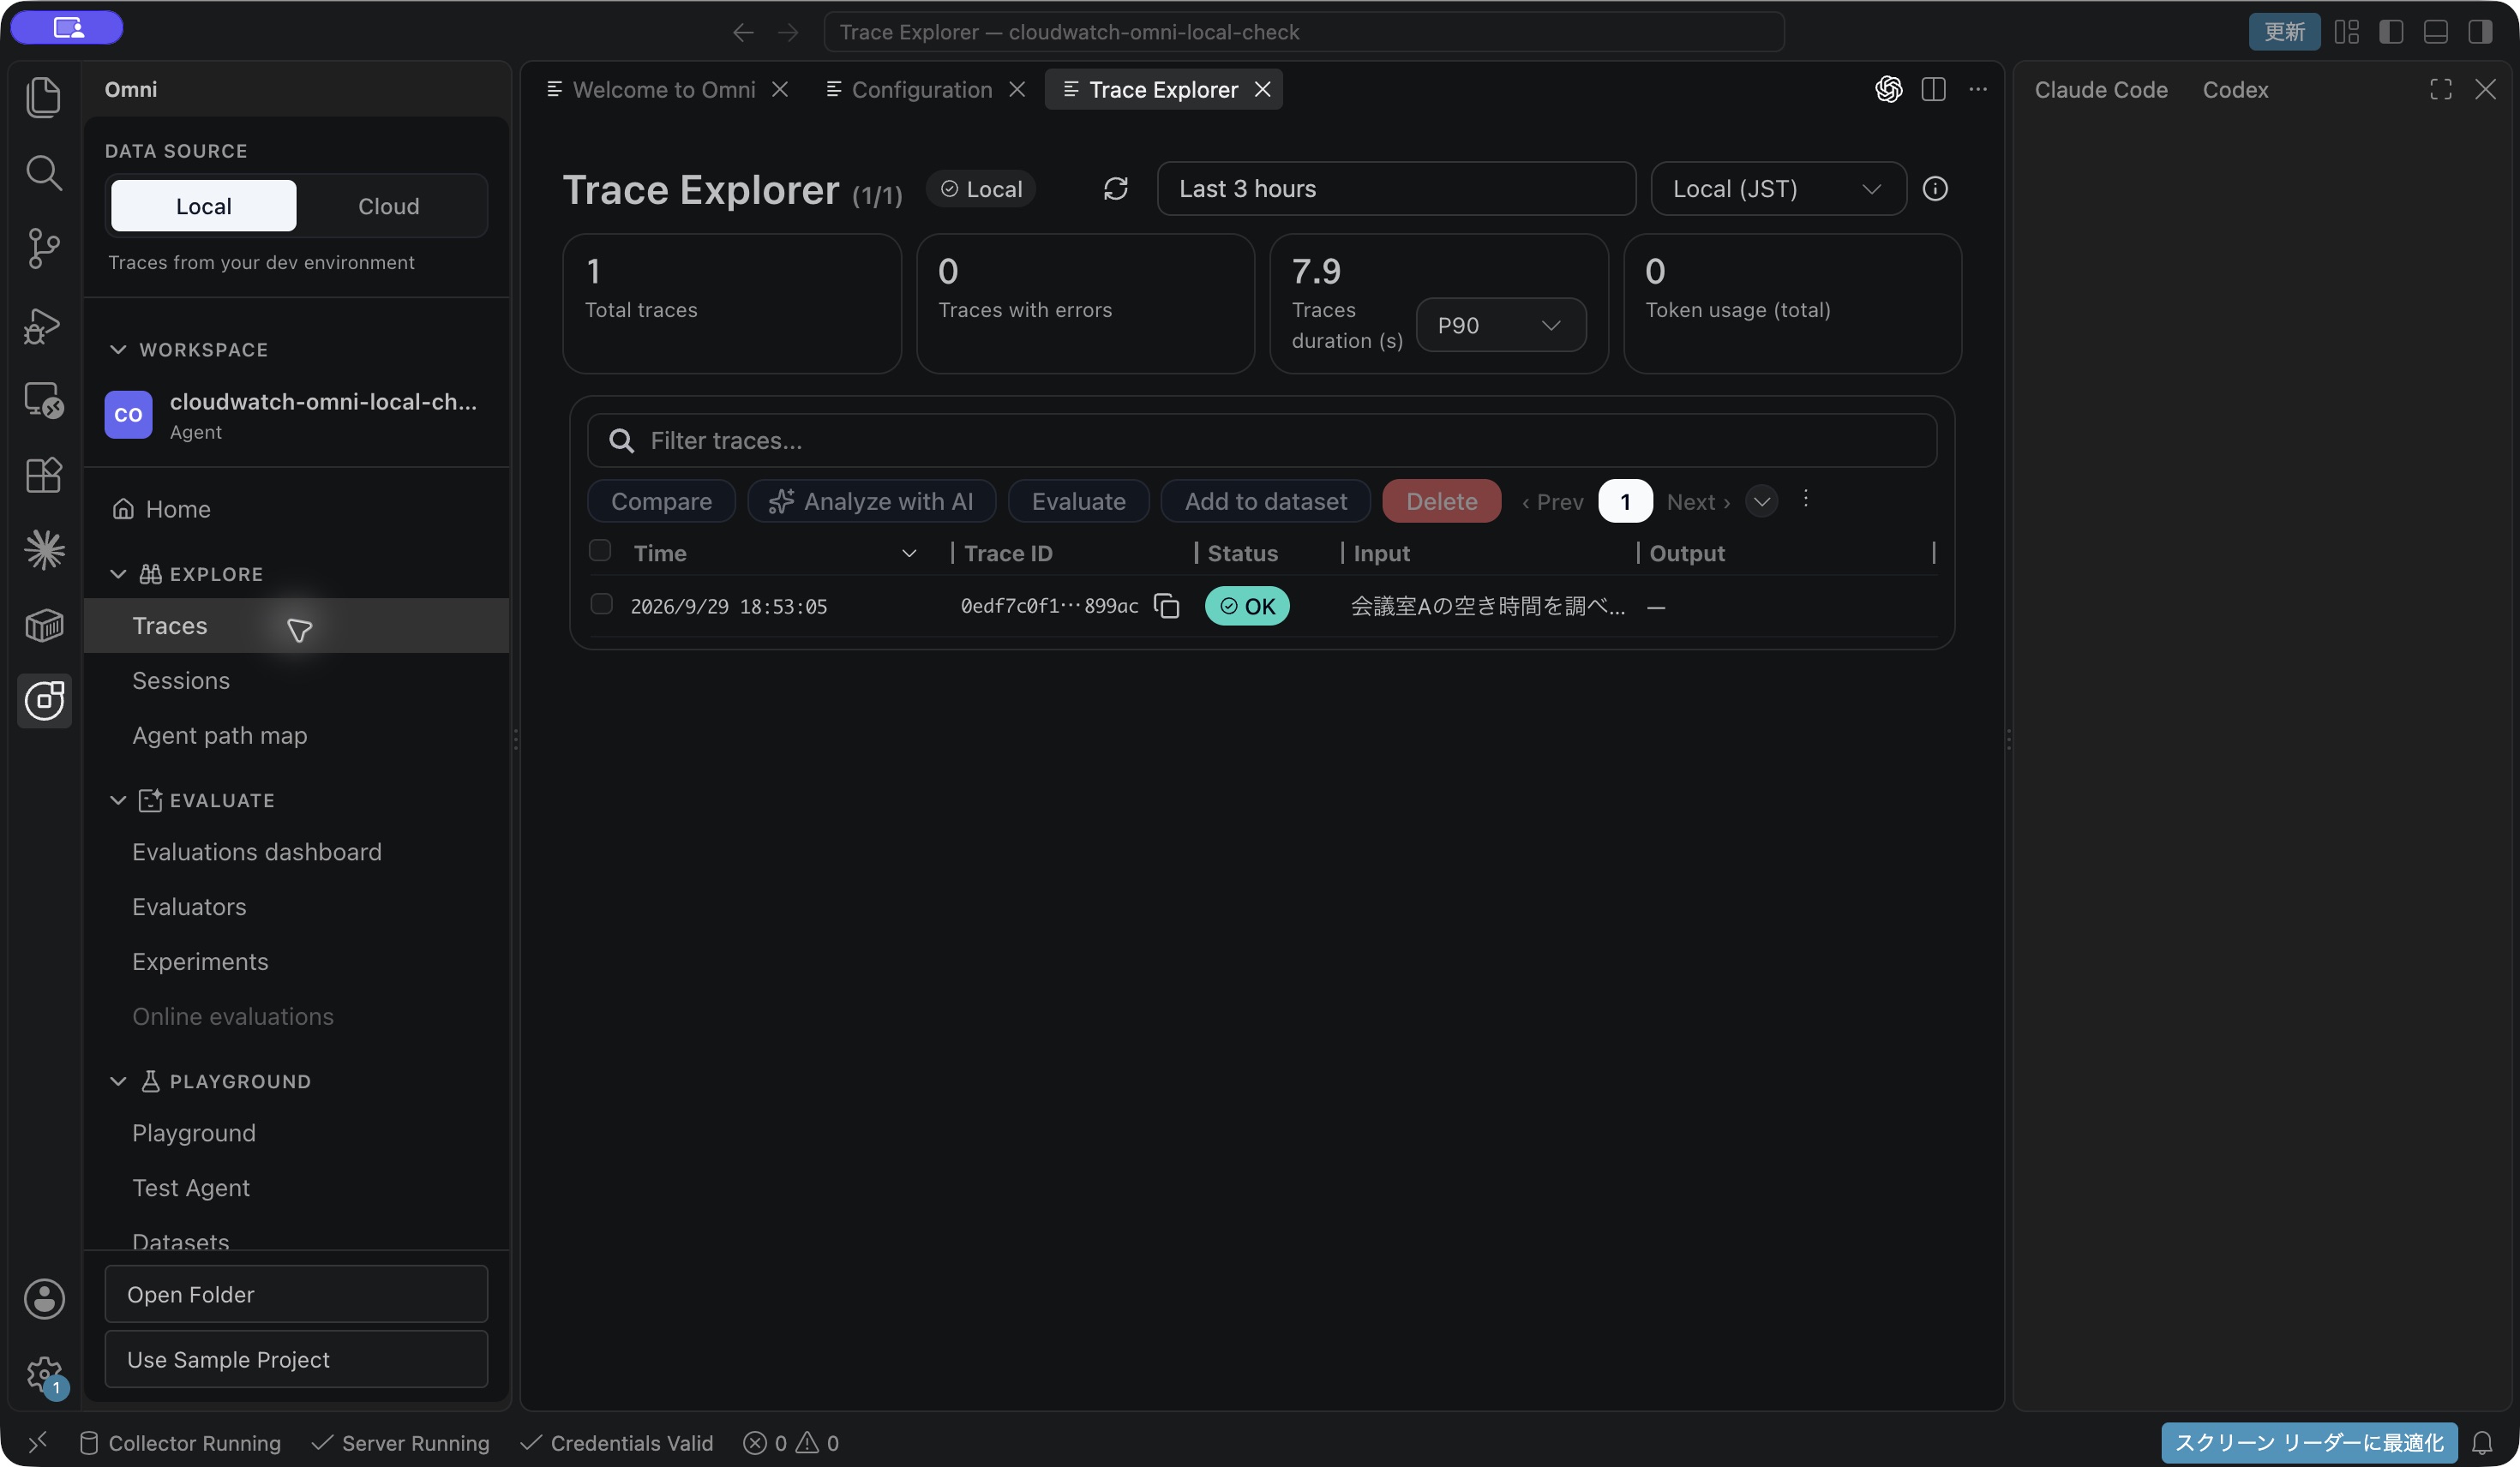
導入直後の実画面です。この時点ではトレースはありません。
IDE拡張のドキュメントには、拡張からサーバーを起動すると、ローカルコレクターの起動とOpenTelemetry環境変数の設定を行うと書かれています。今回はその経路を使いました。
モデル呼び出しとツール実行を分けた
examples/cloudwatch-omni-local/に、Node.jsの小さなHTTPサーバーを用意しました。POST /invocationsを受けると、ログイン済みのCodex CLIを一度呼び、続けてlookup_roomというローカル関数を実行します。会議室の空き時間は固定のテストデータです。
モデルをローカルで動かす構成ではありません。Codex CLIの呼び出しはOpenAI側への通信を伴います。また、モデルが実際にツールを呼び出す仕組みでもありません。今回はモデルの返答を受けた後、こちらのコードがツールを実行しています。この違いを残しておかないと、画面だけでエージェントの実装を誤解しそうです。
OpenTelemetryのagent.run、chat gpt-6-sol、tool lookup_roomのspanもコードで明示的に作りました。したがって、任意のエージェントを無設定で自動追跡できるかは、この検証では分かりません。
検証用フォルダーで依存パッケージを入れ、OmniのConfigurationに起動コマンドnpm startとポート8080を設定しました。Save & Startでサーバーを起動しています。
npm install --no-audit --no-fund
node --check agent.js最初はオンボーディングの手動設定から始めましたが、言語とフレームワークの選択が必要でした。今回の素のNode.jsスクリプトに合うフレームワークはありません。そこでサイドバーのConfigurationから起動コマンドとポートを直接設定しました。少し遠回りしました。
次のリクエストを1回送ると、モデルの返答とツールの結果がJSONで返りました。
curl -X POST http://127.0.0.1:8080/invocations \
  -H 'Content-Type: application/json' \
  -d '{}'
{
"choice": "会議室Aの空き時間を調べるには lookup_room を使います。",
"room": {
"room": "A",
"date": "2026-10-01",
"slots": ["10:00-11:00", "15:00-16:00"]
}
}Omniで見えた情報
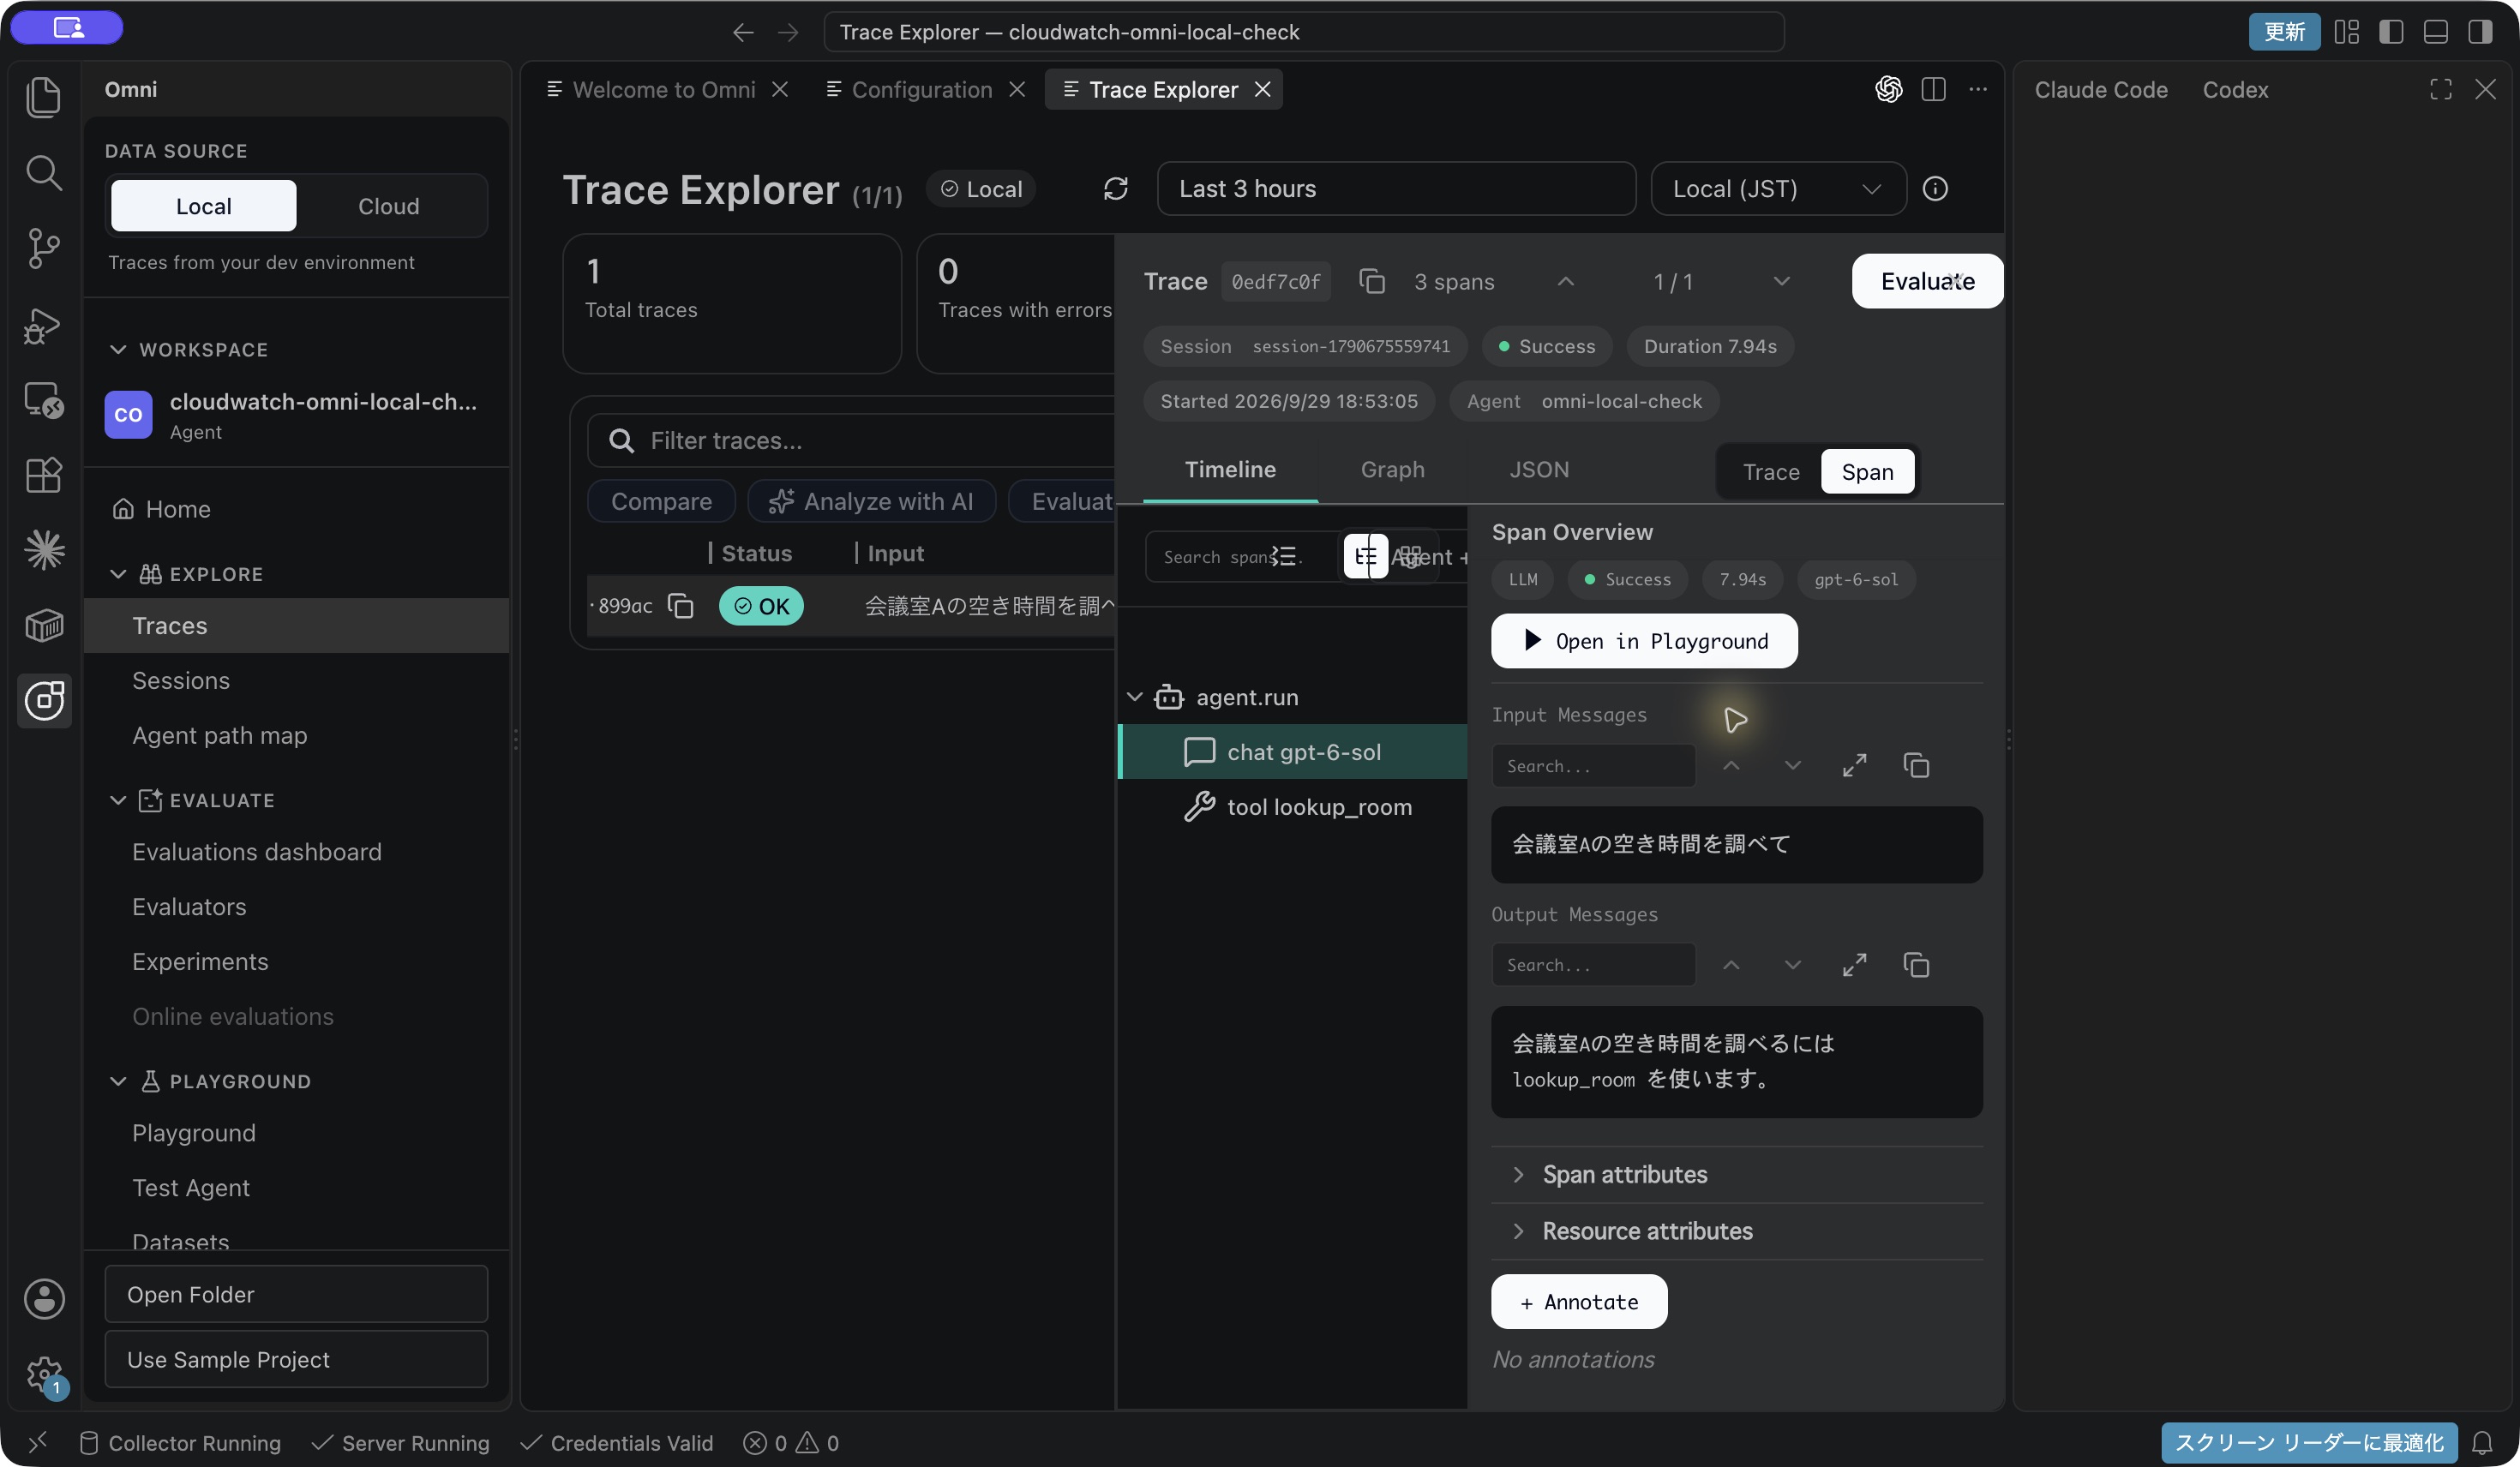
Trace Explorerには1件のトレースが入りました。詳細を開くと、親のagent.runの下にモデル呼び出しとツール実行が並びます。画面では3 spans、LLMが1件、ツールが1件、全体の実行時間は7.94sでした。これは今回の1回の実測値です。
モデルspanを選ぶと、Input Messagesに「会議室Aの空き時間を調べて」、Output Messagesにlookup_roomを使うという返答が出ました。モデル名と実行時間も確認できます。
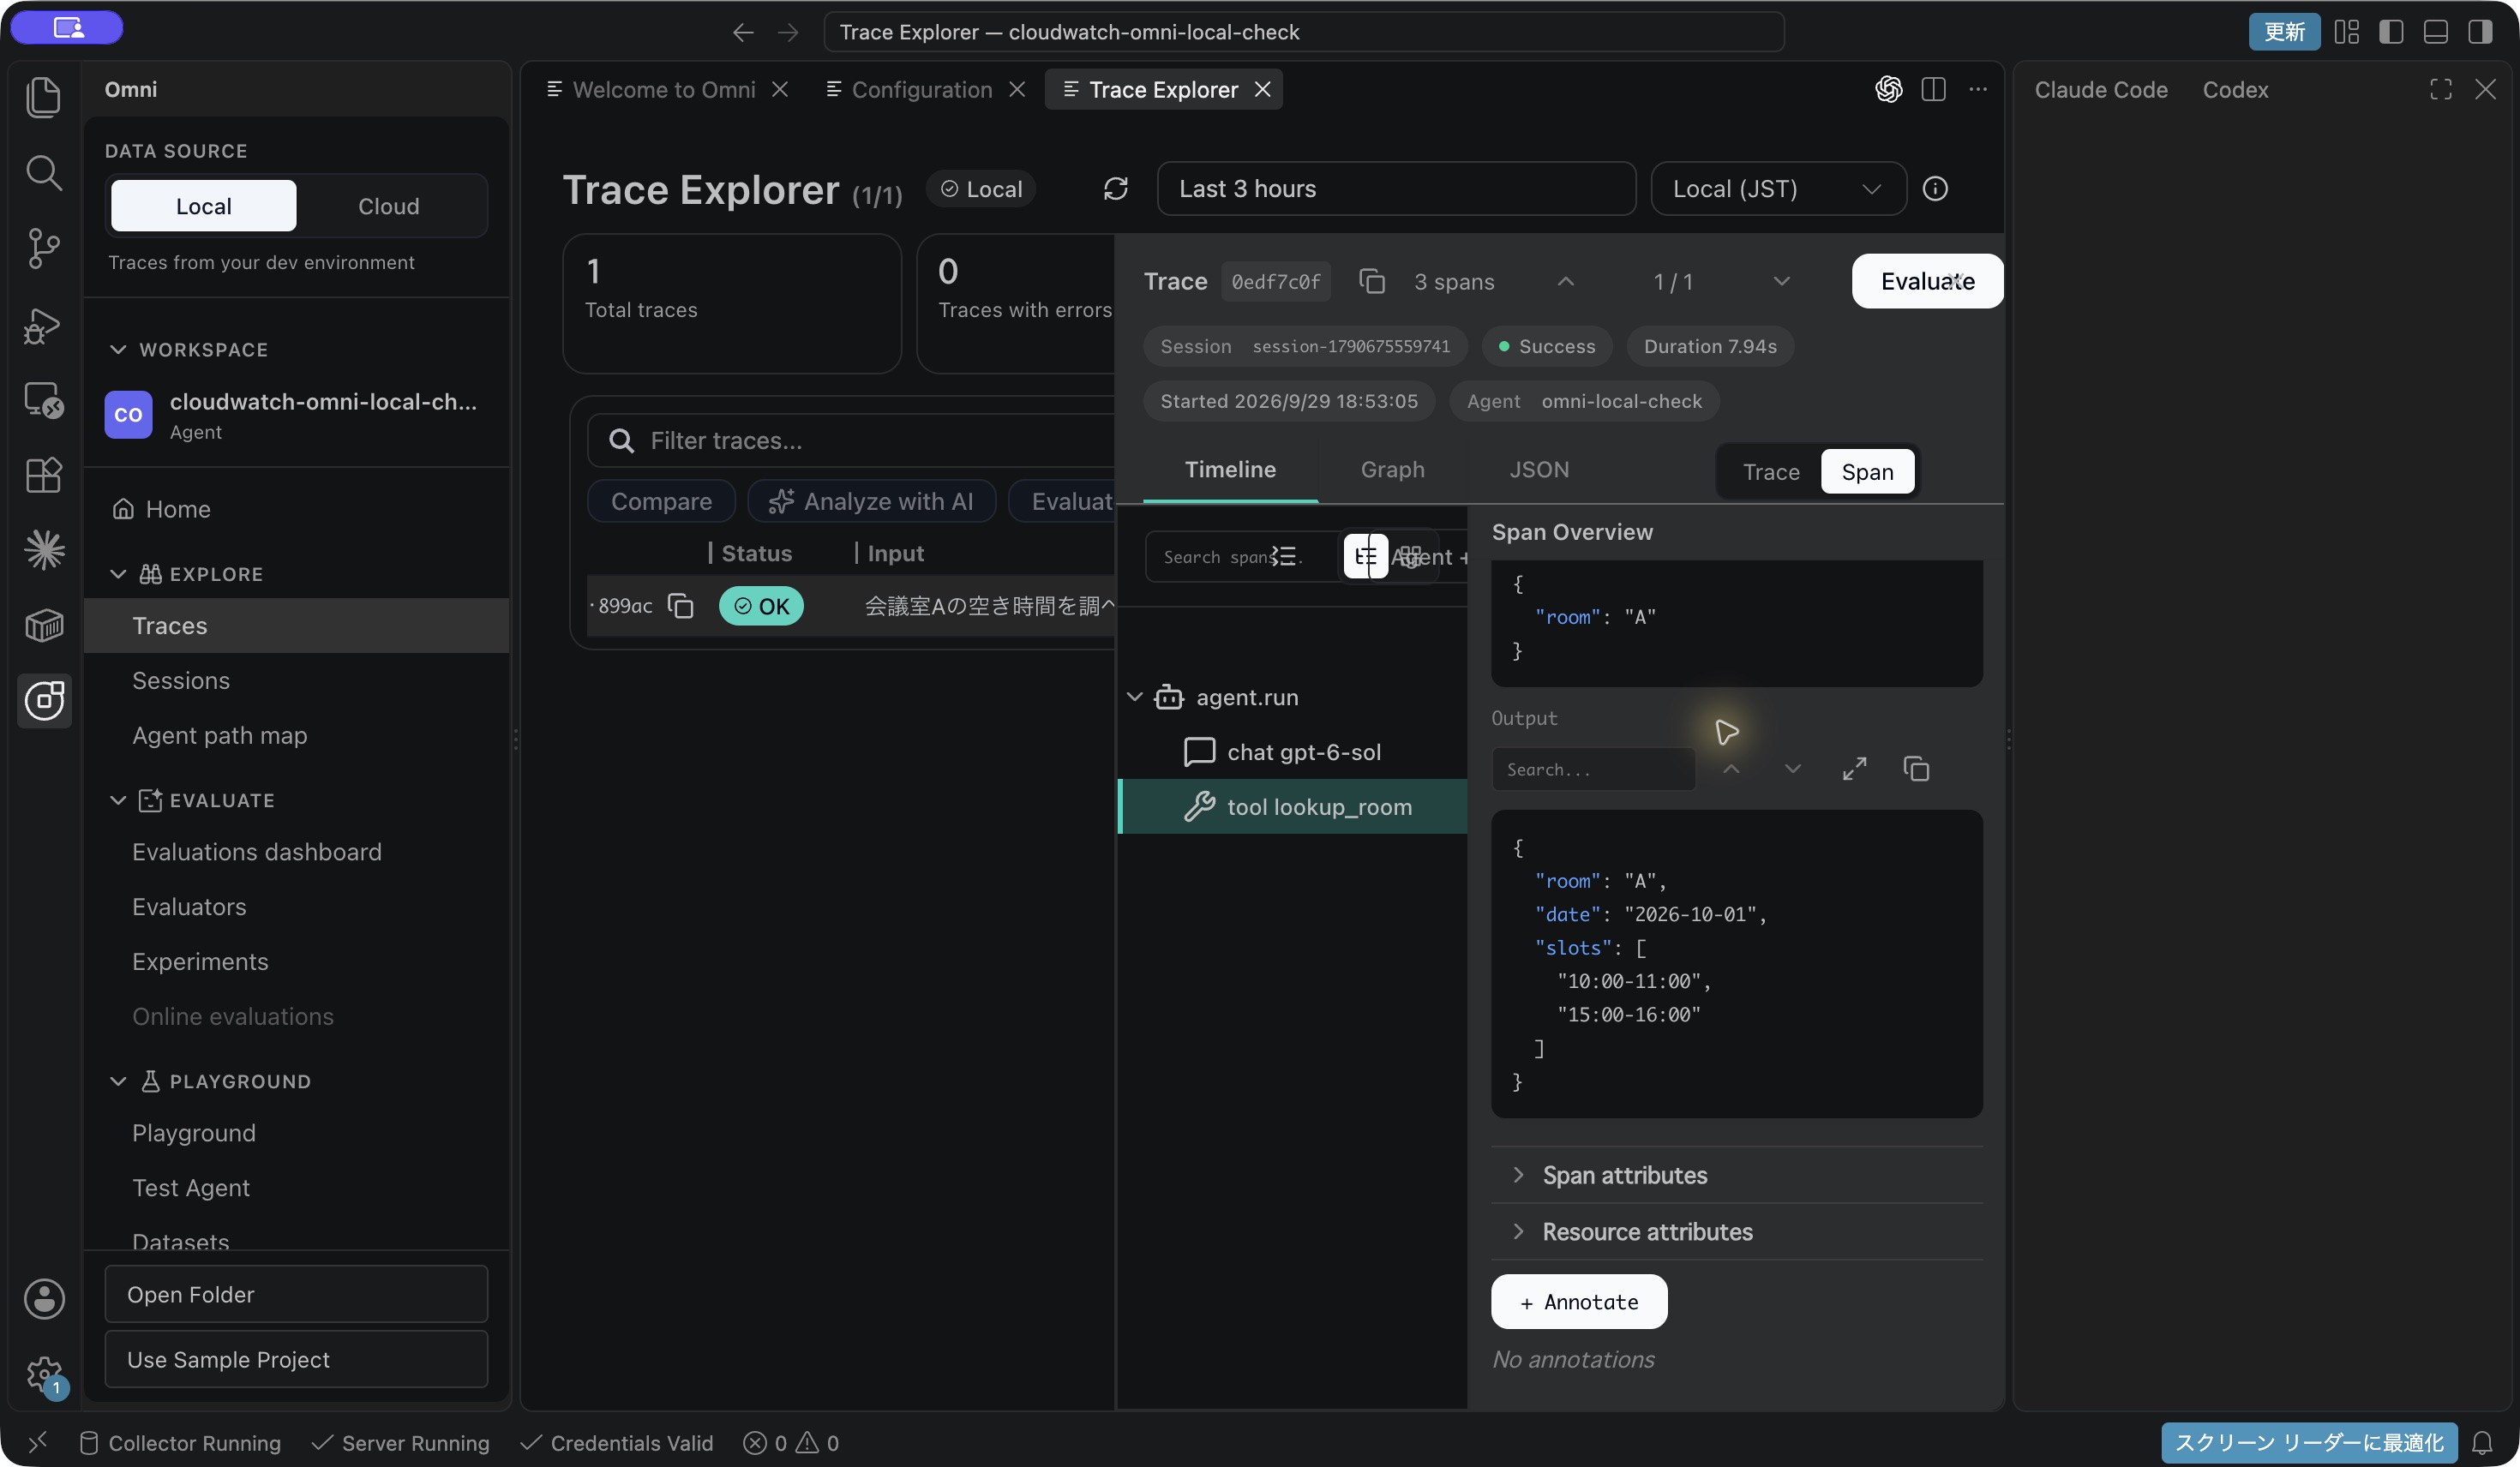
ツールspanでは、引数のroom: Aと、結果のdate、slotsが見えました。ツールの入力と出力を別々に追えるのは、今回知りたかった点です。
見えなかった情報
| 対象 | 今回の結果 |
|---|---|
| モデルとツールの順序 | agent.runの下に2つのspanとして表示されました。 |
| モデルの入力・出力 | span詳細で表示されました。 |
| ツールの引数・結果 | span詳細で表示されました。 |
| トークン数 | 一覧とモデルspanで0でした。今回の手書きのspanには使用量を入れていません。実際の消費が0という意味ではありません。 |
| トレース一覧のOutput欄 | 空欄でした。親spanに最終出力を設定していないためだと考えています。span詳細のモデル出力は表示されました。 |
| 評価とPlayground | メニューは確認しましたが、実行していません。 |
| クラウドモード | AWSアカウントには接続していません。 |
とくにトークン数の0は見落としそうでした。Omniが数えられないと決まったわけではありません。今回はCodex CLIを外部プロセスとして呼び、使用量をOpenTelemetryのspanへ渡していないためです。手書きの計装で何を記録したかが、そのまま画面の限界になりました。
所感
モデル呼び出しとツール実行の順番、入力、結果をIDE内で追えることは確認できました。一方、全体の出力やトークン数は、この最小構成では埋まりませんでした。ローカルモードでAWSアカウントが不要でも、トレースを作る計装とモデル側の認証は必要です。
次はOpenAI Agents SDKなど、拡張が案内するフレームワークの計装でも同じ画面を確認したいと思います。今回の手書きspanとの違い、特に使用量と親トレースの出力を比べてみたいです。
ここまで読んでいただき、ありがとうございます。もしこの記事の技術や考え方に少しでも興味を持っていただけたら、ネクストのエンジニアと気軽に話してみませんか。
- 選考ではありません
- 履歴書不要
- 技術の話が中心
- 所要時間30分程度
- オンラインOK


