LLMの中身を理解するため、tiny-jp-llmという小さな日本語LLMを一つずつ作っています。
これまでに、文章をトークンIDへ変換するByte-level BPEトークナイザーと、トークンIDに対応するベクトルを取り出すEmbeddingを作りました。
今回はAttentionへ進む前に、トークンが文章の何番目にあるのかを加える位置EmbeddingをPythonで実装してみます。
今回作るもの
最初に、今回さわる場所を整理しました。
文章
  ↓ トークナイザーで分割する
トークンIDの並び
  ↓ トークンEmbeddingで、IDに対応する行を取り出す
トークンごとのベクトル
  ↓ 【今回】位置Embeddingで、何番目かを表すベクトルを足す
トークンと位置を含むベクトル
  ↓ Attentionで、過去のどのトークンを参照するか計算する
計算後のベクトル
今回は、同じトークンが文章中に2回出てきたとき、置かれた位置によって計算へ渡す値が変わるところまで確認します。
今のEmbeddingに順番は入っているのか
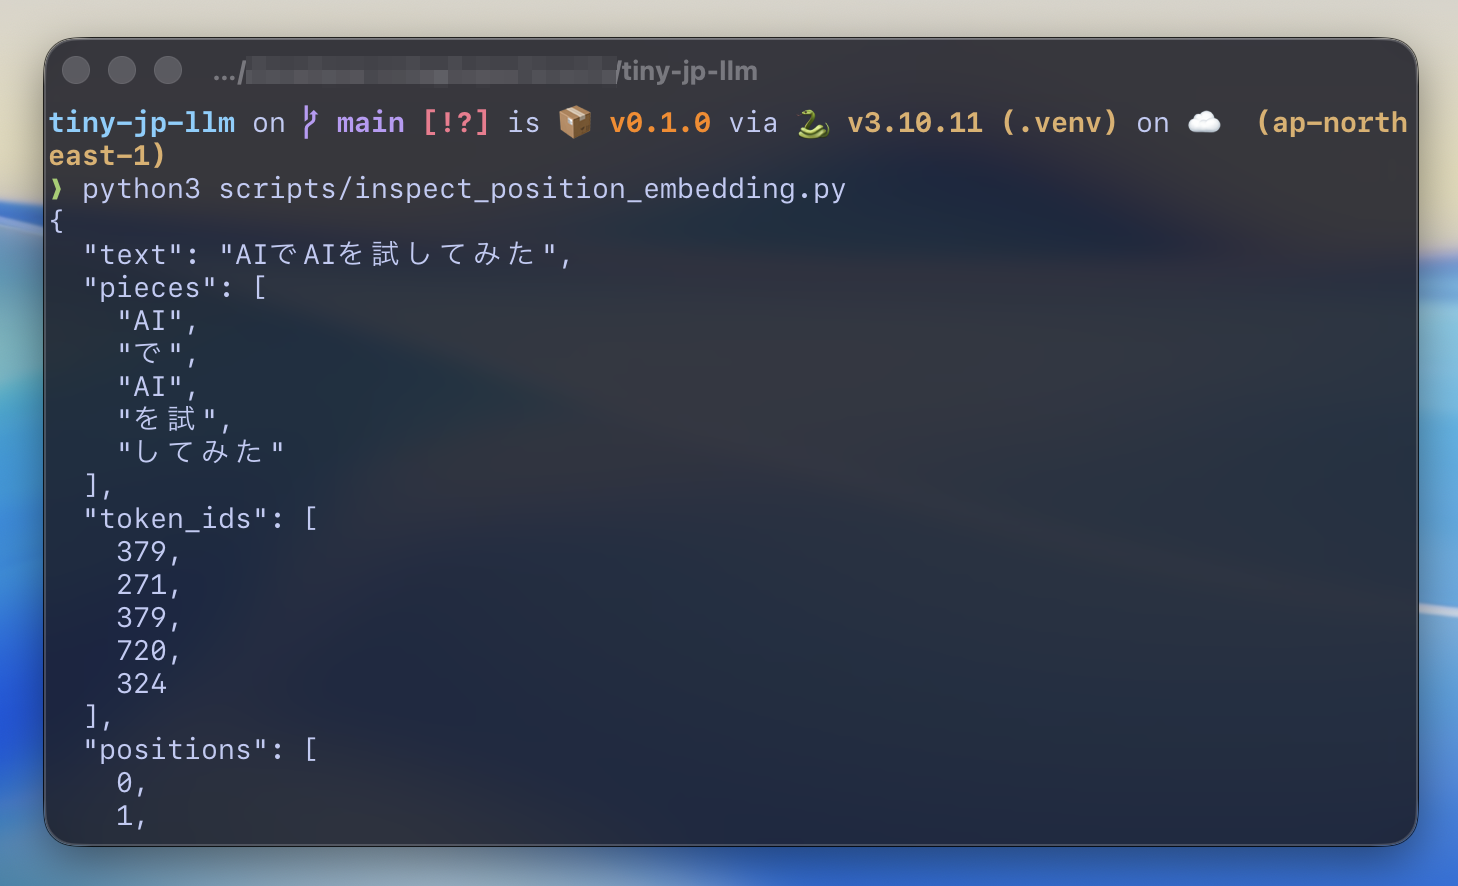
前回作ったトークナイザーへ、AIでAIを試してみたという文章を渡しました。
tiny-jp-llm tokenizer encode \
  --model artifacts/tokenizer-800.json \
  --text "AIでAIを試してみた"
結果は次のようになりました。
{
  "pieces": ["AI", "で", "AI", "を試", "してみた"],
  "token_ids": [379, 271, 379, 720, 324]
}AIは、先頭と3番目に出ています。どちらも同じトークンなので、トークンIDは379です。
前回作ったトークンEmbeddingは、トークンIDを行番号として使い、対応する1行を取り出します。
先頭のAI   → トークンID 379 → 379行目
3番目のAI  → トークンID 379 → 379行目
どちらも同じ行を取り出すため、得られるベクトルも同じです。
文章では登場する場所が違うのに、ここまでの処理ではその違いが値に入っていませんでした。
位置Embeddingについて調べてみる
Transformerの元になった論文を読むと、トークンの並び順を別の値として加えるPositional Encodingが出てきます。
自分なりに読むと、トークン自体を表すベクトルへ、文章中の位置を表すベクトルを足す仕組みのようです。
トークンを表すベクトル
              +
位置を表すベクトル
              ↓
トークンと位置を含むベクトル
元の論文では、位置を表す値をサインとコサインから計算しています。一方で、位置ごとの値をEmbeddingとして用意し、学習によって変更する方法もあるようです。
今回は後者を試します。
前回使ったtorch.nn.Embeddingと同じ仕組みを使えるため、トークンIDの代わりに0番目、1番目という位置を渡せば、処理を追いやすそうだったからです。
実行の準備
コードはGitHubのNXSW/tiny-jp-llmへ置いています。
まだ取得していない場合は、次のコマンドを実行します。
git clone https://github.com/NXSW/tiny-jp-llm.git
cd tiny-jp-llm
このプロジェクト専用のPython環境を作り、PyTorchを含む必要なライブラリをインストールします。
python3 -m venv .venv
source .venv/bin/activate
python3 -m pip install -e .
前回作った語彙をまだ生成していない場合は、記事タイトルの取得とトークナイザーの作成も行います。
tiny-jp-llm corpus fetch-next-titles
tiny-jp-llm experiment bpe-vocabこれで、今回使うartifacts/tokenizer-800.jsonができます。
位置の番号を作る
実装したファイルはsrc/tiny_jp_llm/position_embedding.pyです。
最初に、トークンIDと同じ長さで、0から始まる位置の番号を作ります。
sequence_length = token_ids.shape[-1]
positions = torch.arange(sequence_length, device=token_ids.device)
今回の文章では、次の対応になります。
トークン      AI   で   AI   を試   してみた
トークンID   379  271  379  720    324
位置            0    1    2    3      4
トークンIDは語彙にあるトークンを見分ける番号です。位置は、今回入力した文章の中で何番目にあるかを示す番号です。
どちらも数字ですが、役割は違います。
二つのEmbeddingを作る
トークン用と位置用に、二つのnn.Embeddingを作りました。
self.token_embedding = nn.Embedding(vocab_size, embedding_dim)
self.position_embedding = nn.Embedding(max_sequence_length, embedding_dim)token_embeddingの行数は、トークナイザーが扱えるトークンの種類と同じ800行です。
position_embeddingの行数は、モデルが一度に扱える最大トークン数です。たとえば最大128トークンを扱うなら、位置0から127に対応する128行を用意します。
今回は結果を見やすくするため、1行に入る数値は4個にしました。
二つのEmbeddingから、それぞれ対応する行を取り出します。
token_vectors = self.token_embedding(token_ids)
position_vectors = self.position_embedding(positions)
最後に、同じ場所にある数値同士を足します。
combined_vectors = token_vectors + position_vectors連結して8個の数値にするのではなく、4個と4個を足すため、結果も4個のままです。
実際に動かしてみる
確認用のスクリプトはscripts/inspect_position_embedding.pyです。
次のコマンドを実行します。
python3 scripts/inspect_position_embedding.py出力のうち、2回出てきたAIの部分を抜き出します。
{
  "token": "AI",
  "token_id": 379,
  "positions": [0, 2],
  "token_vectors_equal": true,
  "combined_vectors_equal": false
}token_vectors_equalは、トークンEmbeddingから取り出した値が同じかを比べています。
どちらもトークンID379なので、結果はtrueでした。
combined_vectors_equalは、位置Embeddingを足した後の値が同じかを比べています。こちらはfalseです。
実際のベクトルも見てみます。
先頭にあるAI
トークン: [-1.2464, -1.4996, -0.5404, 1.2410]
位置0:    [ 0.0706, -0.0681,  1.2693, 2.2910]
合計:     [-1.1758, -1.5677,  0.7289, 3.5320]

3番目にあるAI
トークン: [-1.2464, -1.4996, -0.5404, 1.2410]
位置2:    [-1.0722,  0.3390, -0.2217, 2.1397]
合計:     [-2.3186, -1.1607, -0.7621, 3.3807]
トークンのベクトルは同じです。足している位置のベクトルが違うため、合計後の値も変わりました。
これで、同じAIでも、先頭にあるのか3番目にあるのかを異なる値として次の処理へ渡せました。
テストする
表示を眺めるだけではなく、同じトークンを異なる位置へ置いたときの結果をテストにもしました。
output = model.inspect(torch.tensor([2, 1, 2], dtype=torch.long))

self.assertTrue(
    torch.equal(output.token_vectors[0], output.token_vectors[2])
)
self.assertFalse(
    torch.equal(output.combined_vectors[0], output.combined_vectors[2])
)
すべてのテストを実行します。
python3 -m unittest discover -s tests -vRan 19 tests in 1.291s
OK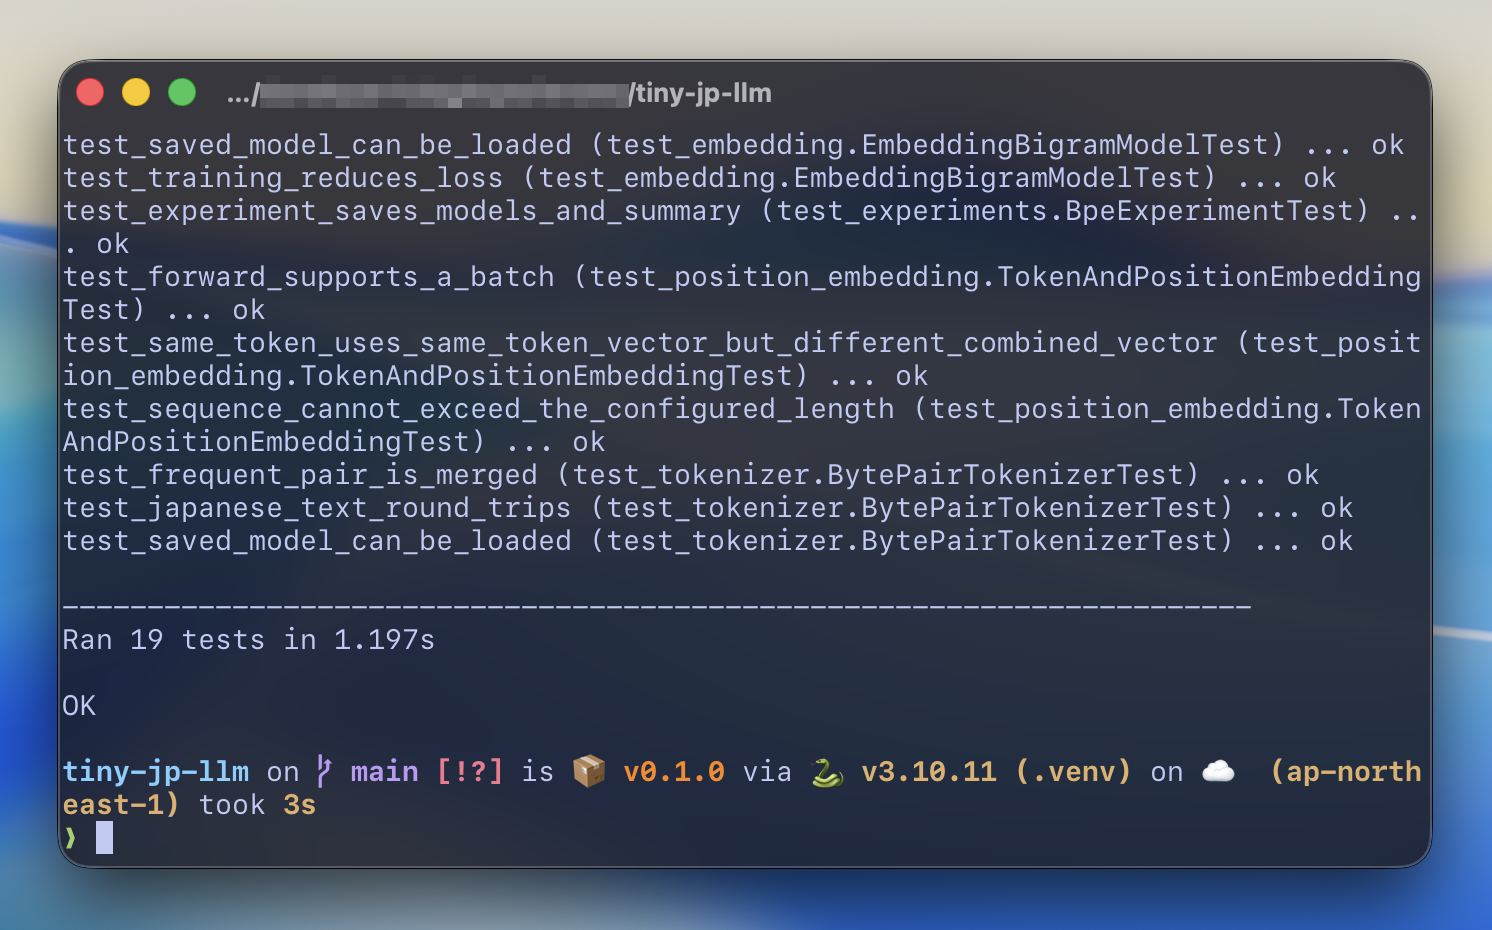
位置を足しただけでは順番を理解したことにならない
異なる位置でベクトルが変わりましたが、モデルが文章の順番を理解したわけではありません。
今回表示した値は、PyTorchが最初に入れた値です。記事タイトルを使った学習も行っていません。
確認できたのは、トークンと位置の情報を一つのベクトルにまとめ、次の計算へ渡せるようになったことです。
次は、このベクトルを使って、過去のどのトークンを参照するか計算するAttentionを作ります。文章の続きを予測するときに未来のトークンを見ないよう、Causal Maskも一緒に試す予定です。
参考
ここまで読んでいただき、ありがとうございます。もしこの記事の技術や考え方に少しでも興味を持っていただけたら、ネクストのエンジニアと気軽に話してみませんか。
- 選考ではありません
- 履歴書不要
- 技術の話が中心
- 所要時間30分程度
- オンラインOK


